
Übersicht
nuwacom verarbeitet Anfragen mit großen Sprachmodellen (LLMs). Diese Modelle erzeugen Text durch Vorhersage, nicht durch Nachschlagen. Daraus ergeben sich Stärken, Grenzen und Fehlerbilder, die auf allen Produktflächen gleich sind: im Chat, in Agents, Workflows und Apps. Diese Seite beschreibt die vier Mechanismen, die das Verhalten bestimmen: die Arbeitsweise des Modells, den Kontext, das Kontextfenster und die Rolle von Quellen.Zentrale Konzepte
- Sprachmodell: Ein statistisches Modell, das aus einer Eingabe die wahrscheinlichste Fortsetzung berechnet. Es besitzt kein Faktenwissen im Sinne einer Datenbank, sondern Muster aus Trainingsdaten.
- Trainingsstand: Der Zeitpunkt, bis zu dem Trainingsdaten reichen. Ereignisse, Produkte und Zahlen nach diesem Zeitpunkt sind dem Modell ohne Quelle unbekannt.
- Halluzination: Eine inhaltlich falsche, aber sprachlich plausible Ausgabe. Sie entsteht systembedingt, wenn das Modell eine Lücke mit der wahrscheinlichsten Fortsetzung füllt.
- Kontext: Die Gesamtheit der Informationen, die dem Modell bei einer Antwort vorliegen: Prompt, Chatverlauf, Anhänge, ausgewählte Quellen, Workspace-Konfiguration.
- Kontextfenster: Die maximale Menge an Kontext, die ein Modell pro Anfrage verarbeitet, gemessen in Tokens.
- Grounding: Die Bindung einer Antwort an bereitgestellte Quellen (Wissensdatenbank, Anhänge, Konnektoren, Websuche) statt an Trainingsdaten.
Wofür dieses Wissen benötigt wird
- Fehlerbilder einordnen: Erfundene Zahlen, vergessene Vorgaben in langen Chats und allgemeine statt unternehmensspezifische Antworten haben jeweils eine klare Ursache und eine klare Gegenmaßnahme.
- Konfiguration auf der richtigen Ebene: Vorgaben wirken je nach Ablageort für eine Antwort, einen Chat oder den gesamten Workspace.
- Quellenwahl vor der Anfrage: Ob Wissensdatenbank, Anhang oder Websuche aktiv ist, entscheidet über Herkunft und Prüfbarkeit der Antwort.
- Prüfaufwand gezielt einsetzen: Prüfung dort, wo Modelle systematisch scheitern, nicht dort, wo sie zuverlässig sind.
Funktionsweise eines Sprachmodells
Ein Sprachmodell zerlegt Eingaben in Token (Wortbestandteile) und berechnet für jede Position die wahrscheinlichste Fortsetzung. Die Ausgabe entsteht Token für Token. Das Modell greift dabei nicht auf eine Faktendatenbank zu und führt keine Nachschlagevorgänge aus, sofern keine Quelle oder kein Tool eingebunden ist. Fachwissen, Argumentationsmuster und Stil stammen aus den Trainingsdaten. Die Ausgabe ist nicht deterministisch: Dieselbe Eingabe kann bei Wiederholung zu abweichenden Formulierungen und in Grenzfällen zu abweichenden Inhalten führen.Zuverlässige und unzuverlässige Aufgaben
Halluzination
Fehlt dem Modell eine Information, bricht es nicht ab, sondern erzeugt die statistisch plausibelste Fortsetzung. Eine erfundene Kennzahl, ein erfundener Paragraf oder ein erfundener Ansprechpartner erscheinen mit derselben Sicherheit und Formulierungsqualität wie korrekte Angaben. Sprachliche Merkmale wie Flüssigkeit, Struktur oder Nachkommastellen sind kein Indikator für Richtigkeit. Halluzinationen lassen sich reduzieren, nicht ausschließen. Die wirksamsten Hebel in nuwacom sind aktive Quellen, die Anweisung, Lücken zu benennen statt zu füllen, und die Prüfung der unter „Ergebnisse prüfen” genannten Kategorien.nuwacom stellt mehrere Modelle zur Auswahl. Sie unterscheiden sich in Geschwindigkeit, Kontextfenster und Leistungsfähigkeit bei komplexen Aufgaben, nicht im hier beschriebenen Grundverhalten. Trainingsstand und Fenstergröße sind modellabhängig und ändern sich mit Releases.
Kontext
Kontext ist die Gesamtheit dessen, was das Modell bei der Erzeugung einer Antwort als Eingabe erhält. Nur dieser Inhalt beeinflusst die Antwort. Inhalte anderer Chats, nicht angehängte Dateien oder nicht ausgewählte Quellen sind für das Modell nicht vorhanden.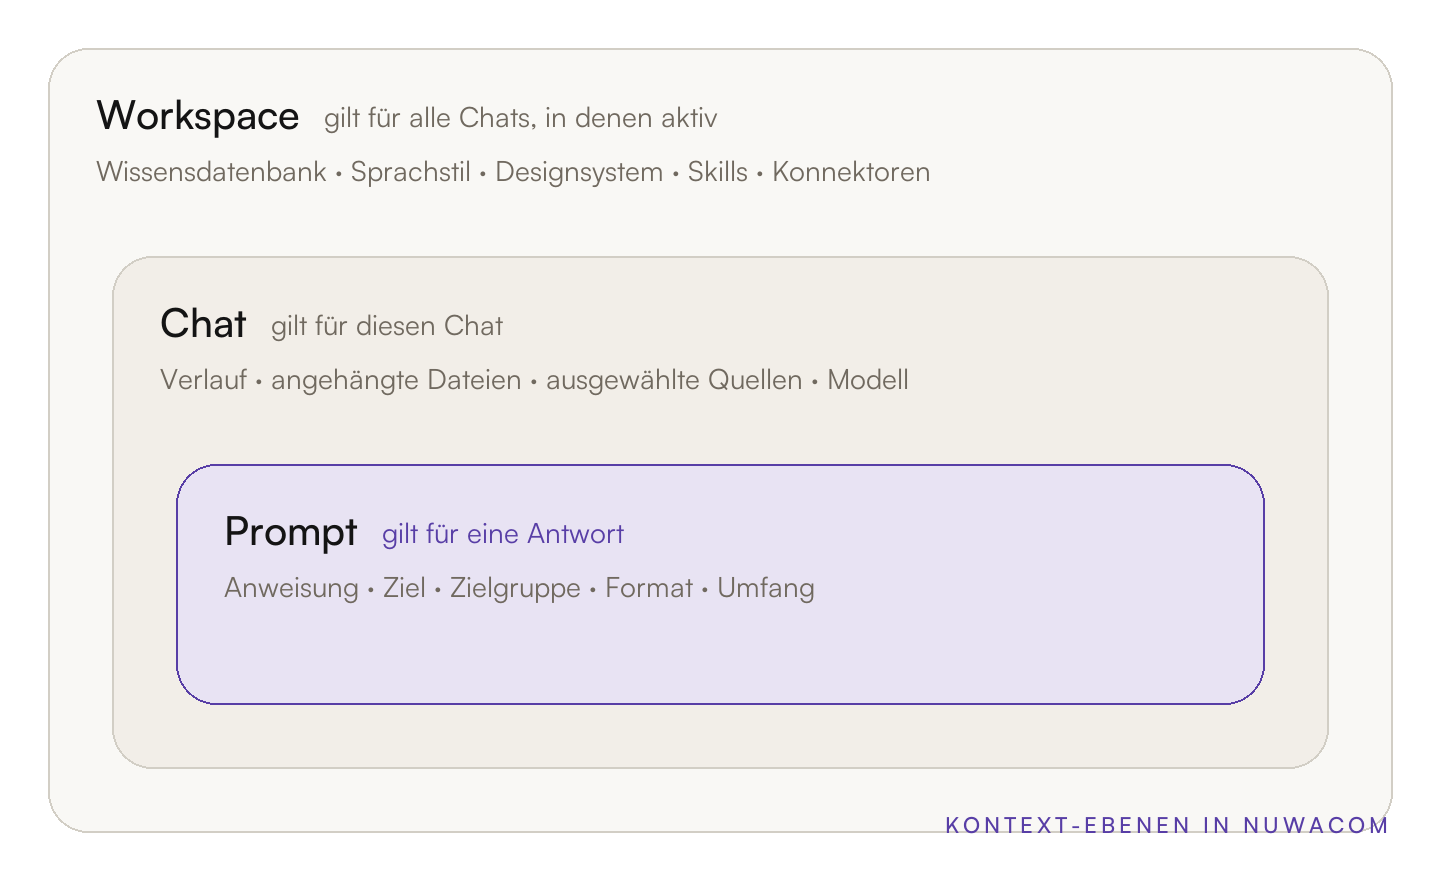
Drei Ebenen von Kontext: Prompt (gilt für eine Antwort), Chat (gilt für den Verlauf), Workspace (gilt überall, wo aktiv).
Daraus folgt die Ablageregel: Eine Vorgabe gehört auf die Ebene, auf der sie gelten soll. Ein Markenton wird einmal als Sprachstil hinterlegt, nicht in jedem Prompt wiederholt. Eine Preisliste liegt in der Wissensdatenbank, nicht als wiederkehrender Anhang.
Priorität bei Widersprüchen. Widersprechen sich Vorgaben verschiedener Ebenen, gewinnt in der Regel die spezifischere und jüngere Anweisung: Der Prompt kann Chat-Vorgaben für eine Antwort überschreiben, der Chat kann Workspace-Standards für einen Verlauf anpassen. Workspace-Einstellungen mit Richtliniencharakter, etwa Sicherheitsvorgaben in Agents, sind davon ausgenommen und lassen sich nicht per Prompt aufheben.
Aufgabenkontext im Prompt
Das Modell kann Zielgruppe, Zweck und Umfang einer Aufgabe nicht ableiten. Diese drei Angaben verändern das Ergebnis stärker als Formulierungstechniken:- Zielgruppe: Wer liest das Ergebnis, mit welchem Vorwissen?
- Zweck: Welche Entscheidung oder Handlung folgt daraus?
- Umfang und Format: Länge, Struktur, Ausgabeform (Tabelle, Fließtext, Liste)?
Kontextfenster
Das Kontextfenster ist die Obergrenze an Tokens, die ein Modell pro Anfrage verarbeitet. Ein Token entspricht grob drei Vierteln eines englischen Worts; deutsche Texte benötigen wegen längerer Wörter und Komposita mehr Tokens pro Wort. Bei jeder Antwort wird der gesamte bisherige Chat erneut übergeben: alle Nachrichten, alle Antworten, alle Anhänge und die aus Quellen geladenen Abschnitte. Der Füllstand steigt deshalb mit jeder Nachricht. Zwei Effekte treten auf, bevor das Fenster voll ist:- Verdünnung: Je mehr Inhalt im Fenster liegt, desto geringer das relative Gewicht einzelner Anweisungen. Frühe Vorgaben verlieren an Wirkung, insbesondere solche, die in der Mitte eines langen Verlaufs stehen.
- Widersprüche: Mehrere Korrekturen zum selben Punkt liegen gleichzeitig im Fenster. Das Modell gewichtet sie, statt die letzte strikt zu befolgen.
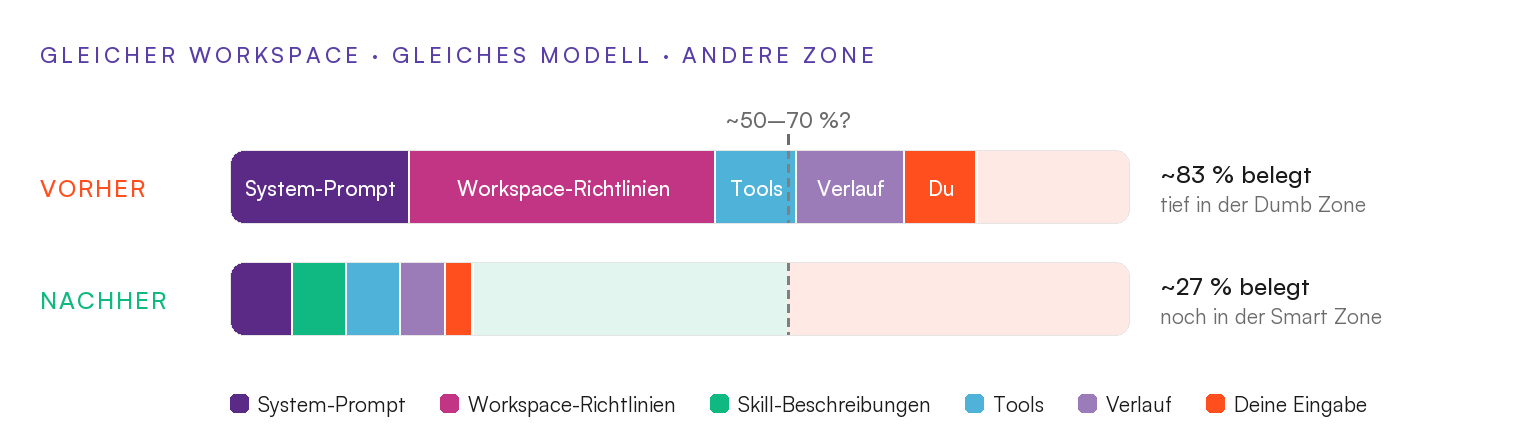
Links ein Chat nach mehreren Korrekturen mit konkurrierenden Vorgaben im Fenster, rechts ein neuer Chat mit der letzten gültigen Version und einer vollständigen Anweisung.
Symptome und Maßnahmen
Quellen und Allgemeinwissen
Ohne aktive Quelle antwortet das Modell aus Trainingsdaten: allgemein gültig, bis zum Trainingsstand, ohne Kenntnis unternehmensinterner Informationen. Mit aktiver Quelle werden relevante Inhalte in den Kontext geladen; die Antwort stützt sich auf diesen Text und kann Fundstellen ausweisen. Dieselbe Anfrage „Wie viele Tage pro Woche sind im Homeoffice erlaubt?”, zwei Ergebnisse:
Formulierungen wie „in den meisten Unternehmen”, „üblicherweise” oder „in der Regel” sind ein Hinweis darauf, dass keine Quelle verwendet wurde.
Wie Quellen in den Kontext gelangen
Die Wissensdatenbank wird nicht vollständig übergeben. Pro Anfrage werden per semantischer Suche die relevantesten Abschnitte ermittelt und in das Kontextfenster geladen. Daraus folgen zwei Eigenschaften:- Treffergenauigkeit hängt von der Anfrage ab: Eine präzise Frage mit den Begriffen des Dokuments findet die passenden Abschnitte zuverlässiger als eine allgemeine.
- Lücken werden gefüllt: Enthält kein geladener Abschnitt die gesuchte Information, antwortet das Modell aus Trainingsdaten weiter, ohne dies zu kennzeichnen, sofern es nicht ausdrücklich angewiesen wird, Lücken zu benennen.
Quellentypen im Vergleich
Prompt-Baustein für quellengebundene Antworten:
Ergebnisse prüfen
Ausgaben eines Sprachmodells sind Entwürfe. Die Prüfung konzentriert sich auf die Kategorien, in denen Modelle systematisch unzuverlässig sind:Prüfmethoden in nuwacom
- Fundstelle anfordern: „Zeige die Stelle im Dokument, aus der diese Zahl stammt.” Kann das Modell keine Stelle nennen, stammt die Angabe nicht aus der Quelle.
- Herkunft abfragen: „Woher stammt diese Aussage?” Quellengebundene Antworten verweisen auf das Dokument; Antworten aus Trainingsdaten werden umformuliert oder relativiert.
- Rohdaten gegenlegen: Bei Entscheidungsvorlagen die Kennzahlen direkt mit der Quelle abgleichen. Der Aufwand liegt bei wenigen Minuten pro Dokument.
- Zweite Anfrage im neuen Chat: Bei kritischen Aussagen dieselbe Frage ohne Vorgeschichte stellen. Weichen die Antworten ab, ist mindestens eine falsch.
Abbruchkriterien für Korrekturen
Ein neuer Chat ist einer weiteren Korrektur vorzuziehen, wenn eine der folgenden Bedingungen eintritt:- Die zweite Korrektur zum selben Punkt bleibt wirkungslos.
- Das Thema wechselt.
- Zuvor eingehaltene Vorgaben werden ignoriert.
Für Genehmigungen, Sonderfälle sowie rechtliche, steuerliche und arbeitsrechtliche Fragen bleibt das zuständige Fachteam verbindlich. Die Ausgabe aus nuwacom bereitet die Anfrage vor und ersetzt sie nicht.
Was Sprachmodelle nicht können
- Kein Faktenabruf ohne Quelle: Das Modell schlägt nichts nach. Ohne aktive Quelle, Konnektor oder Websuche stammt jede Angabe aus Trainingsdaten.
- Kein Wissen nach dem Trainingsstand: Ereignisse, Releases und Preise nach diesem Zeitpunkt sind unbekannt, außer sie werden über eine Quelle bereitgestellt.
- Keine Kenntnis anderer Chats: Verlauf und Anhänge gelten pro Chat. Chatübergreifend wirkt nur die Workspace-Ebene.
- Keine verlässliche Arithmetik: Mehrstufige Berechnungen und Aggregationen über viele Werte sind fehleranfällig. Für exakte Ergebnisse eignet sich die Datenanalyse mit Code-Ausführung.
- Keine Unsicherheitsanzeige: Das Modell signalisiert nicht zuverlässig, wenn es rät. Sicherer Tonfall ist kein Qualitätsmerkmal.
- Keine Garantie auf Vollständigkeit: Antworten beruhen auf den geladenen Abschnitten, nicht zwingend auf dem gesamten Dokumentbestand.
- Keine Reproduzierbarkeit: Dieselbe Anfrage kann unterschiedliche Ausgaben erzeugen.
Gut zu wissen
- Modellwechsel ändert das Grundverhalten nicht: Ein anderes Modell behebt weder ein volles Kontextfenster noch eine fehlende Quelle.
- Quellenauswahl vor der Anfrage: Eine nachträglich aktivierte Quelle wirkt erst auf die nächste Antwort, nicht rückwirkend.
- Eine Aufgabe pro Chat: Themenwechsel im selben Chat verschlechtern die Ergebnisse beider Themen.
- Zwischenstände sichern: Eine passende Version als Inhalt speichern oder in einen neuen Chat übernehmen, bevor weiter iteriert wird.
- Allgemeinformulierungen als Signal: „Üblicherweise”, „in den meisten Fällen”, „in der Regel” deuten auf eine Antwort ohne Quelle hin.
- Prüfung nach Inhalt, nicht nach Eindruck: Struktur, Flüssigkeit und Detailgrad sagen nichts über Richtigkeit aus.
Beispiel-Prompts
- „Zielgruppe Geschäftsführung, Zweck Budgetentscheidung, Umfang eine Seite: Fasse den Anhang entsprechend zusammen.”
- „Antworte nur aus der Wissensdatenbank und nenne zu jeder Aussage Dokument und Abschnitt.”
- „Zeige die Stelle im Dokument, aus der die Zahl 12,4 Prozent stammt.”
- „Welche Aussagen in deiner letzten Antwort stammen nicht aus den aktiven Quellen?”
- „Hier ist die letzte gültige Version. Überarbeite sie nach folgenden vollständigen Vorgaben: …”
FAQ
Warum nennt das Modell eine Regel, die in unserer Richtlinie nicht steht?
Warum nennt das Modell eine Regel, die in unserer Richtlinie nicht steht?
Entweder war keine Quelle aktiv, oder die geladenen Abschnitte enthielten die Information nicht und das Modell hat die Lücke aus Trainingsdaten gefüllt. Abhilfe: Quelle aktivieren, Fundstelle anfordern, Prompt-Baustein für quellengebundene Antworten verwenden.
Warum hält sich das Modell in einem langen Chat nicht mehr an frühere Vorgaben?
Warum hält sich das Modell in einem langen Chat nicht mehr an frühere Vorgaben?
Das Kontextfenster ist stark gefüllt; frühe Anweisungen sind verdünnt oder abgeschnitten. Abhilfe: neuer Chat mit letzter gültiger Version und vollständig neu formulierten Vorgaben.
Ist eine Antwort mit Websuche geprüft?
Ist eine Antwort mit Websuche geprüft?
Nein. Websuche liefert aktuelle, aber ungeprüfte Inhalte. Die URL ermöglicht die Prüfung, ersetzt sie nicht.
Sieht das Modell Dateien aus anderen Chats?
Sieht das Modell Dateien aus anderen Chats?
Nein. Anhänge und Verlauf gelten pro Chat. Chatübergreifend verfügbar sind nur Inhalte auf Workspace-Ebene, etwa die Wissensdatenbank.
Hilft ein stärkeres Modell gegen Halluzinationen?
Hilft ein stärkeres Modell gegen Halluzinationen?
Begrenzt. Leistungsfähigere Modelle halluzinieren seltener, aber nicht nie. Aktive Quellen und Fundstellenprüfung wirken stärker als der Modellwechsel.
Warum liefert dieselbe Anfrage unterschiedliche Antworten?
Warum liefert dieselbe Anfrage unterschiedliche Antworten?
Sprachmodelle arbeiten nicht deterministisch. Abweichende Formulierungen sind normal; abweichende Fakten sind ein Prüfsignal.
Kann das Modell Summen und Kennzahlen aus einer Tabelle berechnen?
Kann das Modell Summen und Kennzahlen aus einer Tabelle berechnen?
Nur eingeschränkt zuverlässig. Für exakte Berechnungen eignet sich die Datenanalyse mit Code-Ausführung.